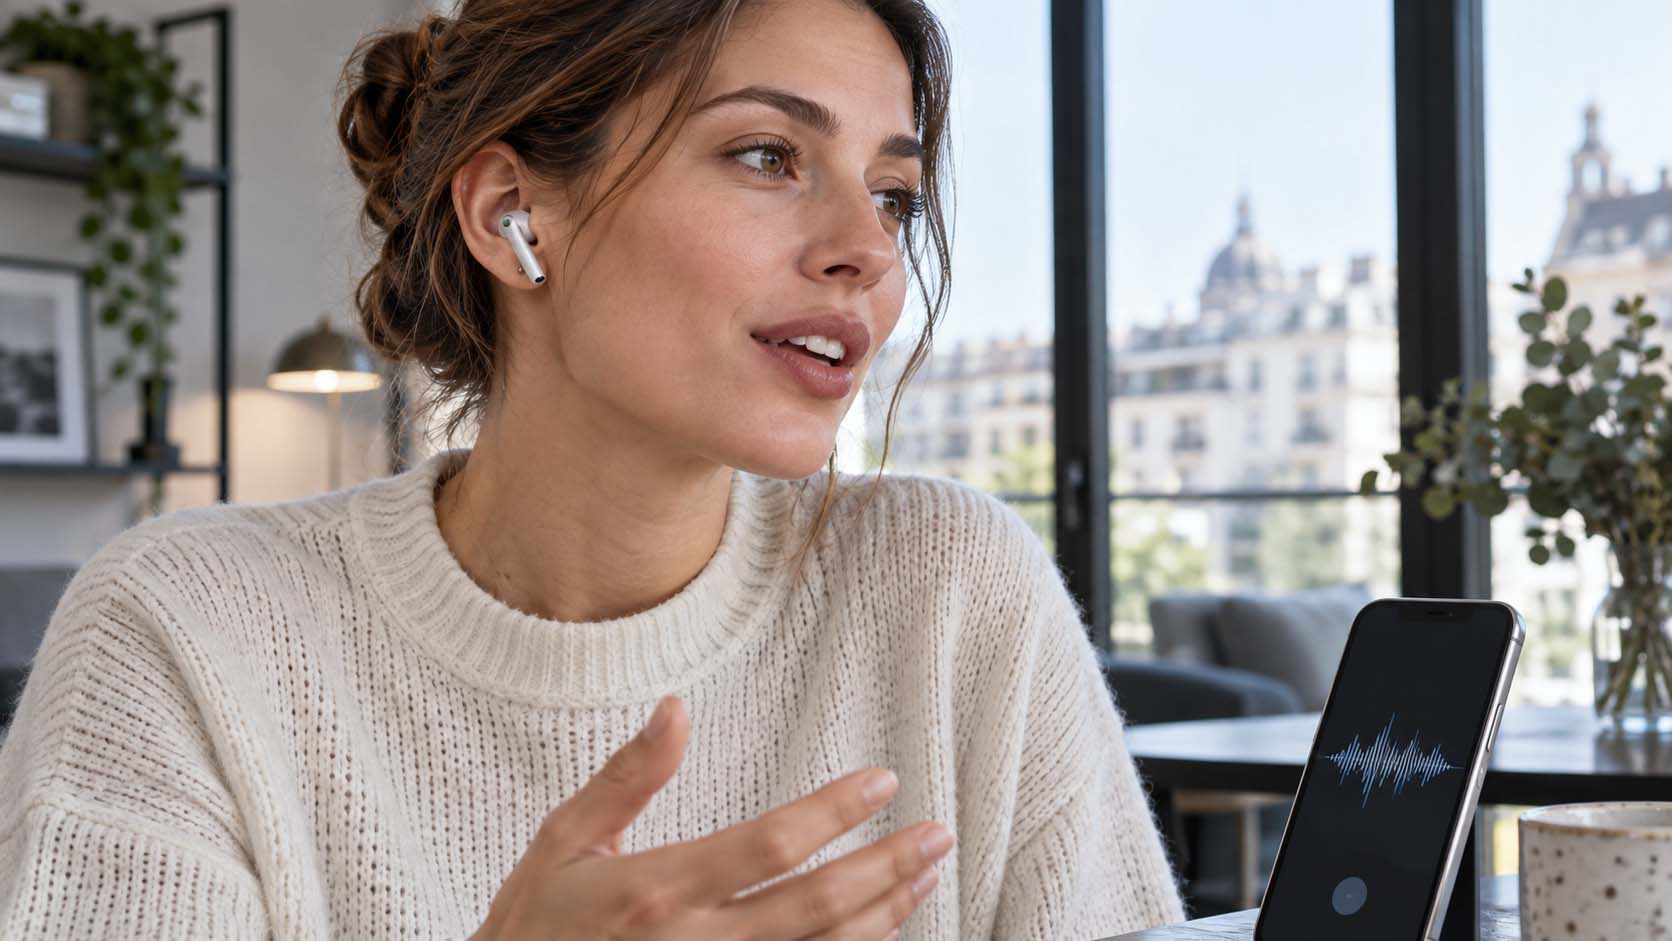
Pametne slušalice mogu da prepoznaju govor zahvaljujući kombinaciji mikrofona, elektronske obrade signala i softvera za prepoznavanje govora. Kada korisnik izgovori naredbu ili pitanje, slušalice najpre registruju promene pritiska u vazduhu, a zatim te promene pretvaraju u električni signal koji uređaj može da obradi.
Sam proces nije isto što i jednostavno snimanje glasa. Mikrofon registruje i govor i zvukove iz okruženja, pa sistem pokušava da izdvoji ono što korisnik govori. Nakon toga se obrađeni signal pretvara u podatke koje algoritam može da analizira i poveže sa određenim rečima ili naredbom.
Mikrofon pretvara govor u električni signal
Mikrofon u slušalici reaguje na promene pritiska koje nastaju kada govorimo. Glasne žice stvaraju promene pritiska koje se kroz vazduh šire kao zvučni talasi, a mikrofon ih pretvara u električni signal koji uređaj može da obradi.
Pametne slušalice često imaju više mikrofona, a njihov raspored omogućava sistemu da poredi signale koji dolaze iz različitih pravaca. Na taj način može da proceni koji zvuk je bliži korisnikovom glasu i da smanji deo buke koja dolazi iz okruženja.
Rezultat nije odmah tekst niti naredba. Dobijeni signal najpre prolazi kroz obradu koja može da ukloni deo neželjenog šuma i pripremi govor za sledeću fazu prepoznavanja.
U toj početnoj fazi sistem može da izjednači određene karakteristike zvuka i izdvoji delove signala koji najviše odgovaraju ljudskom govoru. Tako se sirov zapis sa mikrofona pretvara u pogodniji materijal za dalju analizu.
Sistem pokušava da izdvoji govor iz buke
U stvarnom okruženju korisnik retko govori u potpunoj tišini. Saobraćaj, razgovor drugih ljudi, muzika ili vetar mogu istovremeno stići do mikrofona. Zbog toga slušalice koriste obradu signala kako bi razlikovale karakteristike govora od zvukova koji nisu deo izgovorene poruke.
Više mikrofona može pomoći i kroz usmerenu obradu zvuka. Ako se sličan neželjeni zvuk registruje na više mikrofona, sistem može da ga potisne, dok signal koji odgovara korisnikovom glasu zadržava veću težinu. Efikasnost zavisi od konstrukcije slušalica, položaja mikrofona i samog okruženja.
Digitalni signal se pretvara u podatke koje softver može da obradi
Nakon početne obrade, zvuk se predstavlja kao niz digitalnih podataka. Računarski sistem iz njega izdvaja karakteristike važne za govor, poput promena frekvencije i intenziteta kroz vreme.
Tako se ne obrađuje samo jedna trenutna vrednost, već obrazac koji se menja dok osoba izgovara rečenicu. Softver zatim poredi te obrasce sa modelima govora.
Savremeni sistemi koriste modele mašinskog učenja koji su obučeni na velikom broju primera različitih glasova, izgovora i rečenica. Cilj je da se zvučni signal poveže sa najverovatnijim nizom reči.
Prepoznavanje nije savršeno jer isti glas može zvučati drugačije u zavisnosti od brzine govora, akcenta, izgovora, udaljenosti od mikrofona i buke. Sistem zato ne traži samo identičan zvučni uzorak, već procenjuje koji rezultat najbolje odgovara dostupnim podacima.
Naredba se razlikuje od običnog razgovora
Kod glasovnih funkcija slušalice često ne moraju da razumeju svaku izgovorenu reč. Važno je da prepoznaju obrazac koji odgovara konkretnoj komandi, kao što je pokretanje reprodukcije, promena jačine zvuka ili aktiviranje glasovnog asistenta.
U nekim sistemima važnu ulogu ima fraza za aktivaciju. Kada je prepoznata, uređaj može da počne detaljnije da obrađuje naredni deo govora. To smanjuje potrebu da se čitav zvučni sadržaj neprekidno prosleđuje na obradu i omogućava da glasovna funkcija bude praktičnija za svakodnevno korišćenje. Kada je potrebno složenije razumevanje, obrađeni podaci mogu biti prosleđeni telefonu ili drugom povezanom uređaju, gde se obavlja dodatna analiza. Tačan način rada zavisi od konkretnog modela, njegovog softvera i podešavanja privatnosti.
Zašto slušalice ponekad pogrešno razumeju korisnika
Greške nastaju kada je govor tih, kada korisnik govori iz nepovoljnog položaja ili kada je okruženje veoma bučno. Problem može nastati i kada više ljudi govori istovremeno, jer mikrofoni tada registruju više preklopljenih glasova. Ni napredni algoritmi ne mogu uvek pouzdano da izdvoje željeni signal.
Na rezultat utiču i jezik, dijalekat, izgovor i kvalitet modela koji se koristi za prepoznavanje. Reč koja je jasna u jednom kontekstu može biti pogrešno protumačena kada je izgovorena brzo ili uz buku u pozadini. Zbog toga sistemi koriste verovatnoću i kontekst umesto jednostavnog poređenja pojedinačnih zvukova.
Ukratko, pametne slušalice prepoznaju govor kroz nekoliko povezanih koraka: mikrofon registruje zvučne talase, obrada signala pokušava da izdvoji glas, digitalni podaci se analiziraju, a model govora procenjuje koje su reči ili naredbe najverovatnije izgovorene. Tek tada uređaj može da izvrši odgovarajuću funkciju ili prosledi zahtev dalje.